目录
翻手机相册翻了四十分钟没找到那张照片。于是我用 NAS 上的行影集 TrailSnap,把它变成了一本会翻开的纸质手账:封面有胶带、照片歪歪斜斜贴在日历上、翻页时书页会转过去。整个过程只花了一个周末,照片一张没动。
国庆从西安回来那天下雨,我坐在沙发上翻手机相册,想找一张"城墙下面骑车的背影"。
翻了四十分钟。图库里一共快七万张。
那天晚上我没接着找,而是打开了 NAS 上那套行影集 TrailSnap——一个开源自托管的 AI 相册——然后想了个更麻烦的问题:
既然每张照片都已经带着拍摄时间、地点和 AI 描述,为什么不能直接生成一本"旅行手账"?
不是相册 App 里那种左右划的电子相册,是真的像一本纸质手账:封面贴胶带、书页有颗粒、照片是拍立得的样子歪歪斜斜贴在日历上,点开的时候书页会转过去。
一个周末,它做出来了。
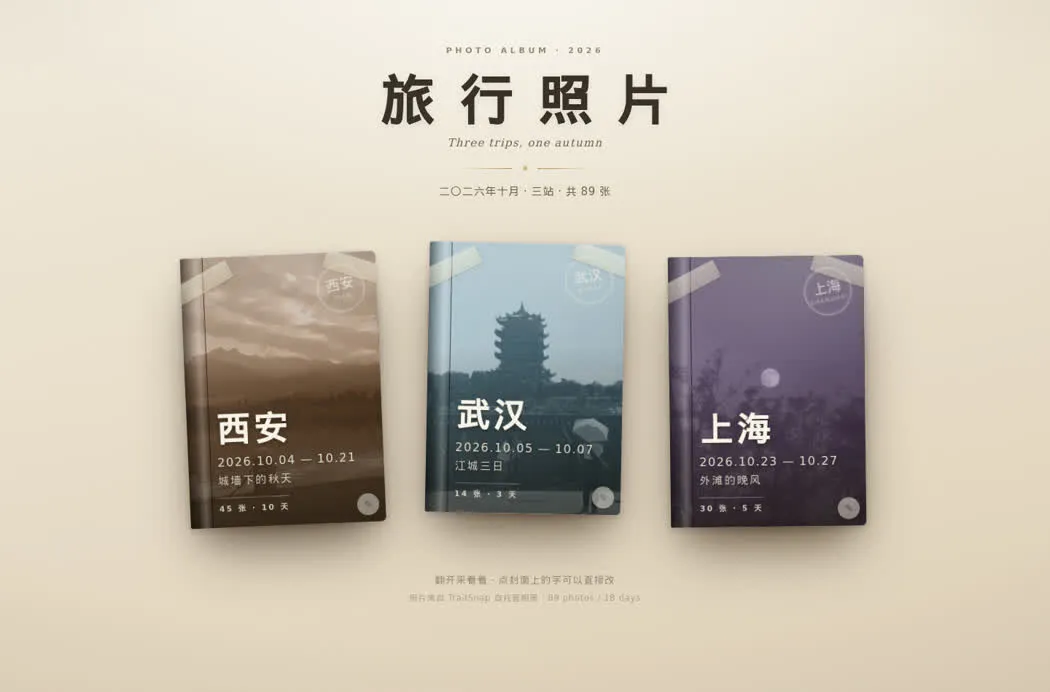 最终成品:三本旅行手账。封面上的地点、日期、副标题都能直接改。
一、原料从哪来:把整个图库当数据源
我的 TrailSnap 跑在 NAS 上,照片还在原来的目录里,一个字节没动。
官方的 trailsnap-cli 是配套的命令行工具,配置一次,图库就能当数据源用:
bashnpm install -g trailsnap-cli
trailsnap config set --url http://<你的NAS地址>:3180 --token <你的Token>
然后:
bashtrailsnap photos list --limit 1
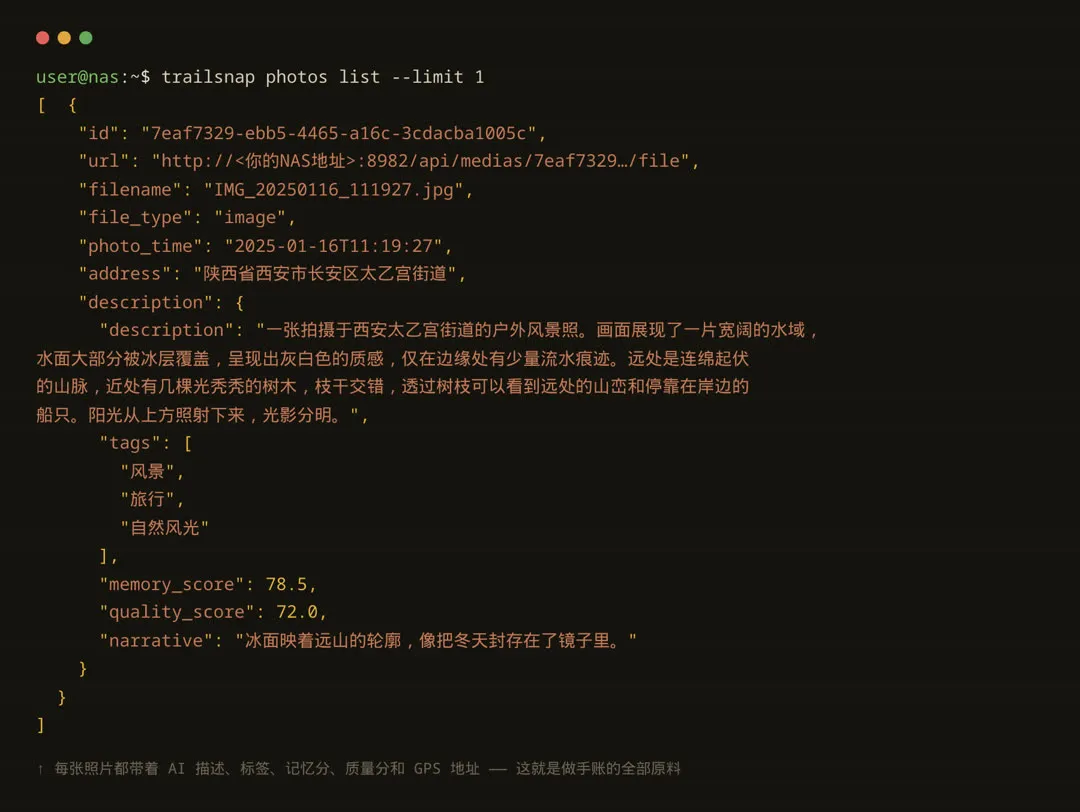 一条命令,返回的每张照片都带着拍摄时间、GPS 地址、AI 描述、标签、记忆分和质量分。
这一条输出里最值钱的其实是三个字段:
photo_time—— 拍摄时间。手账的"这是哪一天"全靠它。address—— 照片拍在哪座城市。这是判断"哪几张属于同一次旅行"的唯一线索。description—— AI 写的照片描述。筛照片的时候全靠它。
照片不用上传、不用导出、不用先整理一遍。 原图还在 NAS 上,工具只是来"读"它的。
二、认出"哪几张属于同一次旅行"
七万张照片,先分城市。TrailSnap 记下了每张照片的 GPS 反查结果(省、市、区、街道),CLI 直接能按城市筛:
bashtrailsnap photos list --city 西安市 --limit 20
我的图库里,西安一万张、上海八百多张、武汉三十七张——光看总量没用,得按时间段再切一刀。脚本把每个城市按拍摄日期排好序,切出一段段连续的行程:
- 西安 —— 10 月 4 日到 10 月 21 日,45 张,横跨 10 天
- 武汉 —— 10 月 5 日到 10 月 7 日,14 张,3 天
- 上海 —— 10 月 23 日到 10 月 27 日,30 张,5 天
最后留了这三本。武汉那三天只有 14 张,但正因为少,翻起来反而最像一本小册子。
三、把不该出现的照片剔掉
图库里混着不少"不该进手账"的东西:截图、文档、开会拍的屏幕。筛选分三层:
- 文件名带
screenshot的直接丢掉——手机截图对旅行手账毫无意义 - 按"值得回忆评分"排序。TrailSnap 给每张照片都打了
memory_score,同一天里分数高的先留,每天最多几张 - 剩下的我一张张看过,把 10 张文档、会议、白板照片手工剔掉
最后留下 89 张照片、18 天。
这一步做完,剩下的就都是值得被贴上去的了。
还有个小便宜:每张拍立得下面那行字,直接用了 TrailSnap 给它写的那句 narrative——"冰面映着远山的轮廓,像把冬天封存在了镜子里"。我一个字没改。
顺带一提:把全库拉下来这件事,我第一次做的时候只拉到 9000 张就以为到底了——分页循环在中途断了。七万这个数字是后来一页一页数出来的。如果你也打算干类似的事,别相信第一次跑出来的总数。
四、让它看起来像手账
这部分没有捷径,是一行行 CSS 调出来的:
- 纸:底色不是纯白,是偏暖的米色,叠一层 SVG 噪点做颗粒,四角压一层暗角
- 胶带:每张拍立得顶部一小条半透明胶带,
rotate(-4deg),带投影 - 拍立得:白边相纸,照片铺满,下面留一条手写体说明
- 随机角度:每张照片的旋转不是
Math.random(),而是拿照片 ID 算了个哈希(FNV-1a)再映射到 ±8.5°——刷新页面角度不会乱跳,但每张还是歪得不一样
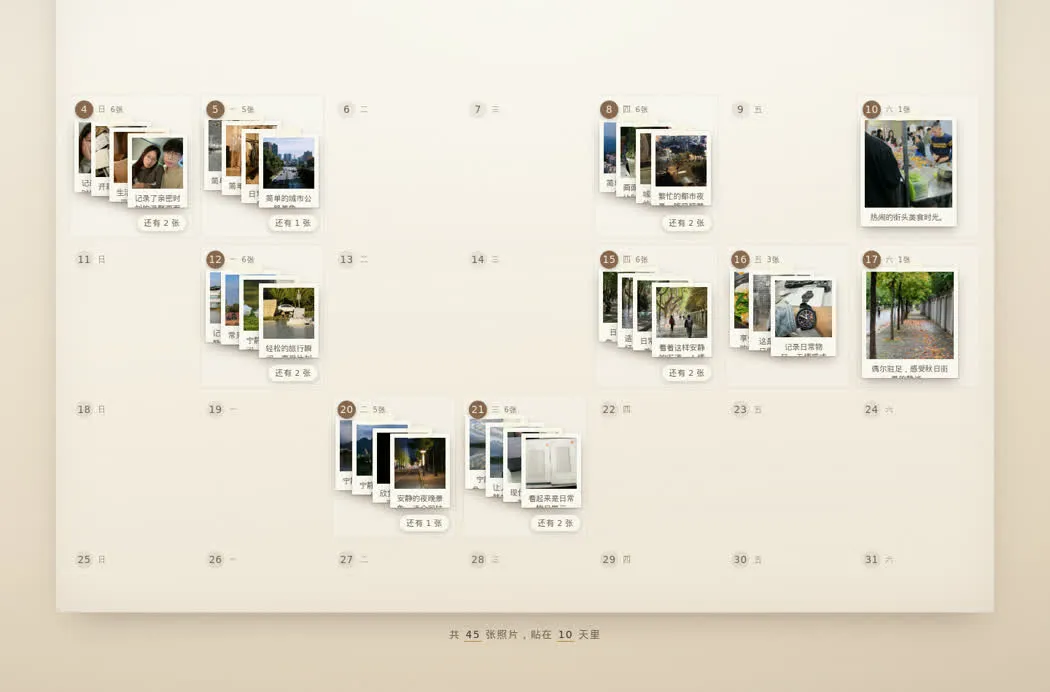 日历页:照片歪歪斜斜贴在对应日期上,一天超过 4 张会折成"还有 N 张"。
日历是七列网格,照片绝对定位在各自的格子里。每个格子用 offsetWidth 量出实际宽度,按比例缩放相纸和错落间距——所以手机上打开也不会糊到格子外面。
五、最难的是"翻开"那一下
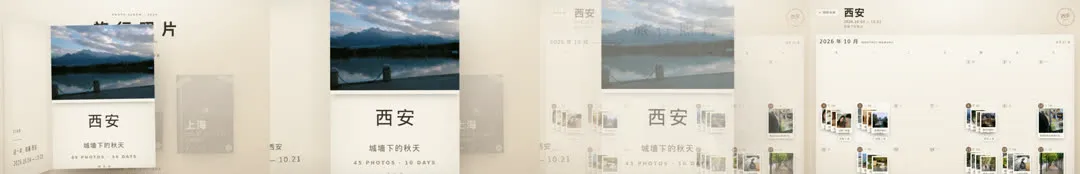 点下去 → 飞到画面中央 → 封面绕书脊转开 → 溶解成日历页。
一开始我把"封面背面"做成 transform: rotateY(180deg),想着像扑克牌那样翻过去。结果封面一转就变成一条线,然后整页空白——因为父级没有跟着翻,背面永远背对着读者。
最后改成了更接近真实书籍的做法:
- 封面做成有正反两面的独立元素:正面是照片封面,背面是封面内侧(空白页 + 标题 + 日期)
- 封面绕左侧书脊旋转 166°,转过去之后自然露出扉页
- 转过 90° 之后,它就是一本摊开的书,而不是一张翻过去的卡片
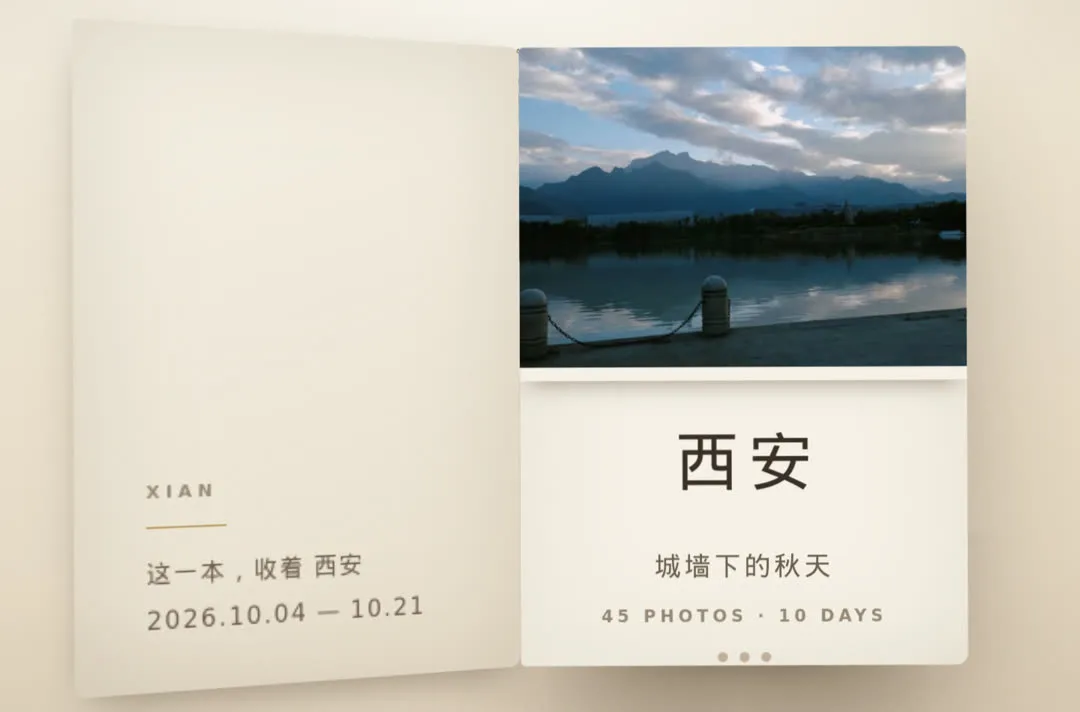 翻开之后:左边是封面内侧,右边是扉页。
还有两个小坑值得记一笔。
一、3D 上下文里 translateZ 不可靠。 原本想让首页用 translateZ(-3px) 退到封面后面,结果在 Chrome 里它反而盖在封面上,页面整个点不动。改成显式 z-index 分层才稳。
二、手机上点击被吞。 封面上的地点和日期做成了可编辑文本,我顺手给它们加了 stopPropagation,结果手机上点书的中心(正好落在文字上)根本没反应——事件压根没冒泡到书。改成只在"编辑模式"下才拦截。
六、成品
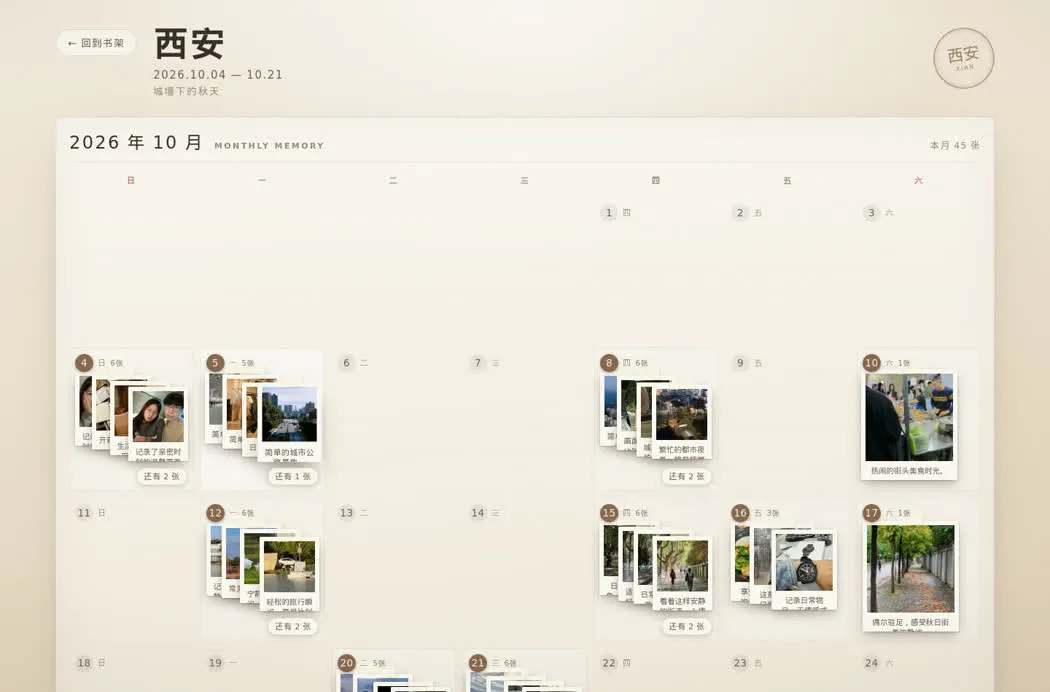 西安:10 月 4 日到 21 日,45 张照片铺在日历上。
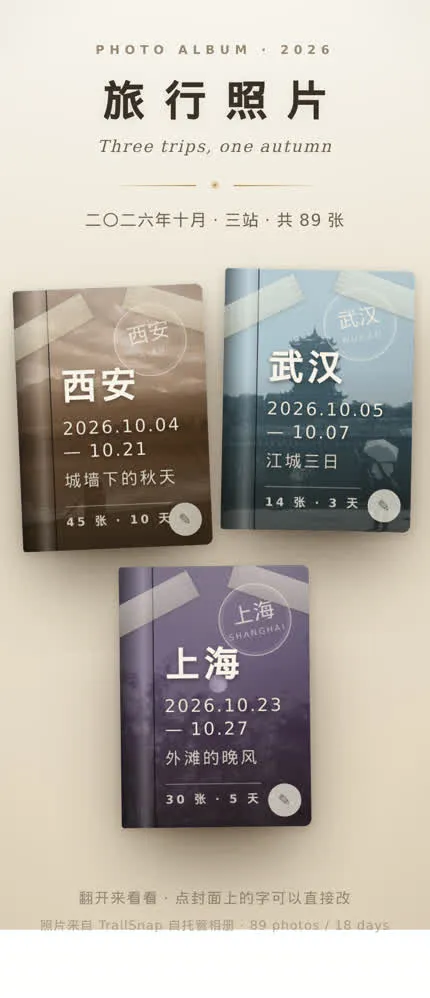 手机上也是同一套:书架、翻开、日历。
封面右下角有个 ✎,点进去就能把地名改成别的、把日期改成别的区间,改完点空白处保存。
整个站点是纯静态的,python3 -m http.server 就能跑起来,没有后端、没有数据库。
七、你也做一个试试
如果你也想让 Agent 直接读你的图库,官方有现成的工具:
bashnpm install -g trailsnap-cli
npx skills add lc044/trailsnap -y -g
装完在 OpenClaw / Claude Code / Cursor 里就能直接说人话,比如:
"帮我查一下最近在上海拍的 20 张照片"
"我去年国庆节去了哪些地方,帮我写一份 HTML 格式的旅行日记"
我的做法更进一步——把 CLI 的输出直接变成一个网站。这套"旅行手账"的生成脚本我留着,想要的话可以在评论区说一声。
最后
行影集 TrailSnap 是开源的(AGPL-3.0),照片、数据库、账号数据都在你自己的服务器或 NAS 上。
你的相册里翻得最多的是哪个城市的照片? 评论区告诉我,我用你的城市做一本试试。
本文作者:司小远
本文链接:
版权声明:本博客所有文章除特别声明外,均采用 BY-NC-SA 许可协议。转载请注明出处!